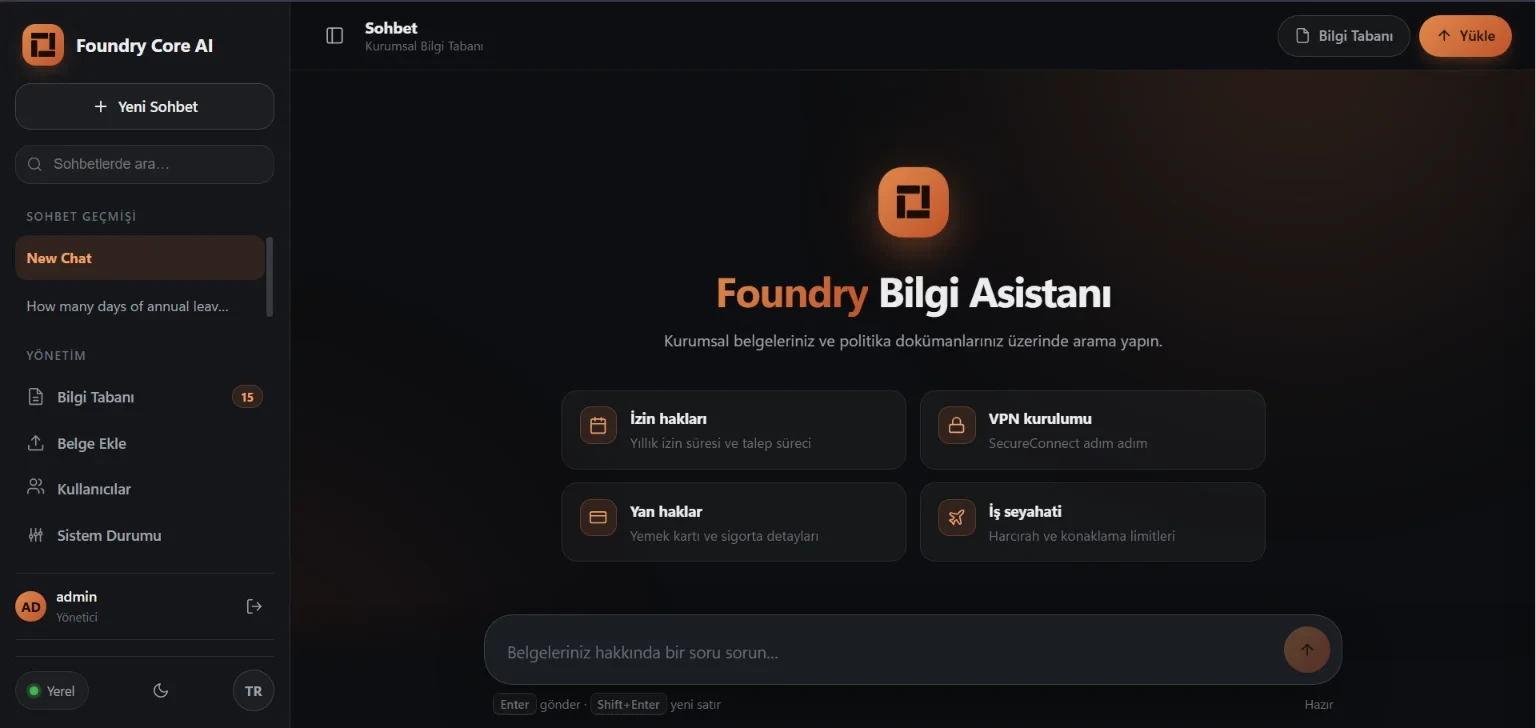
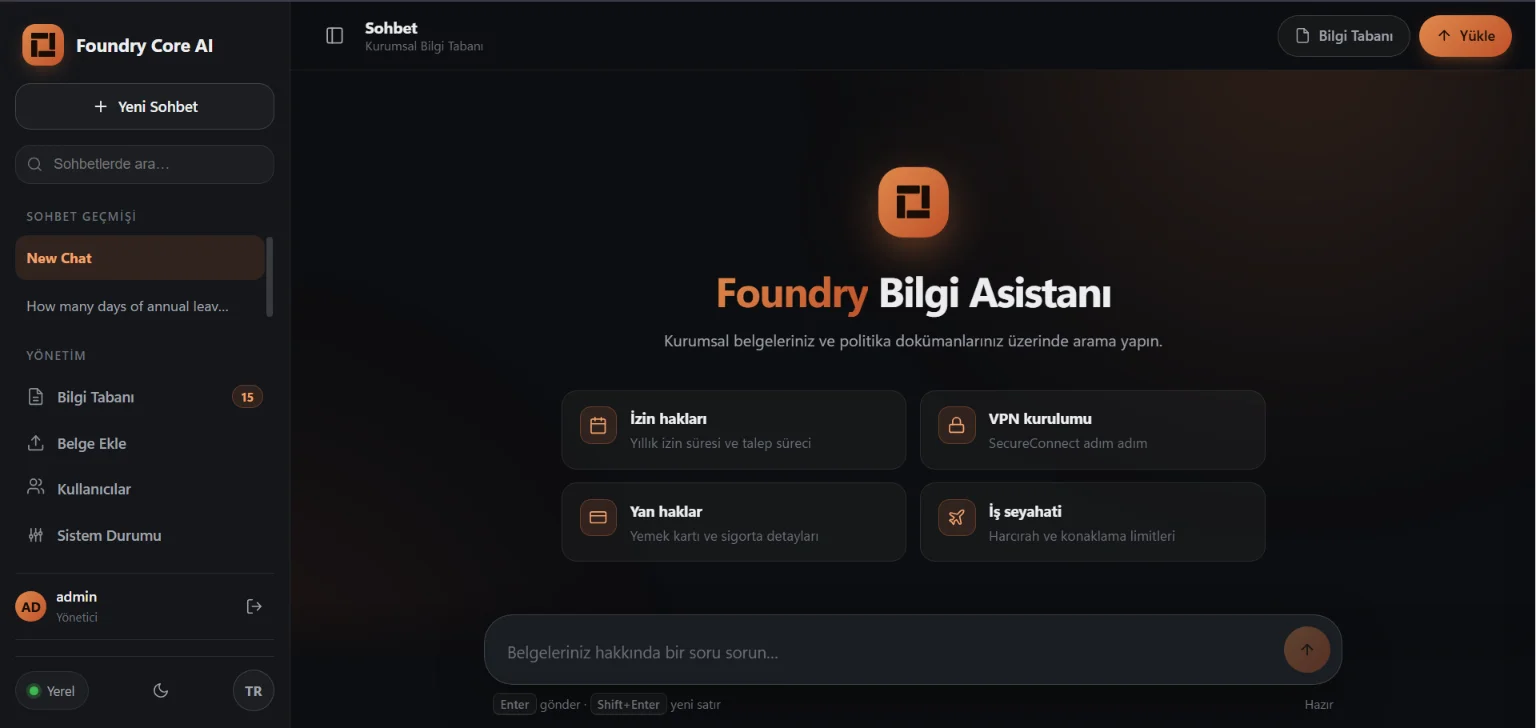
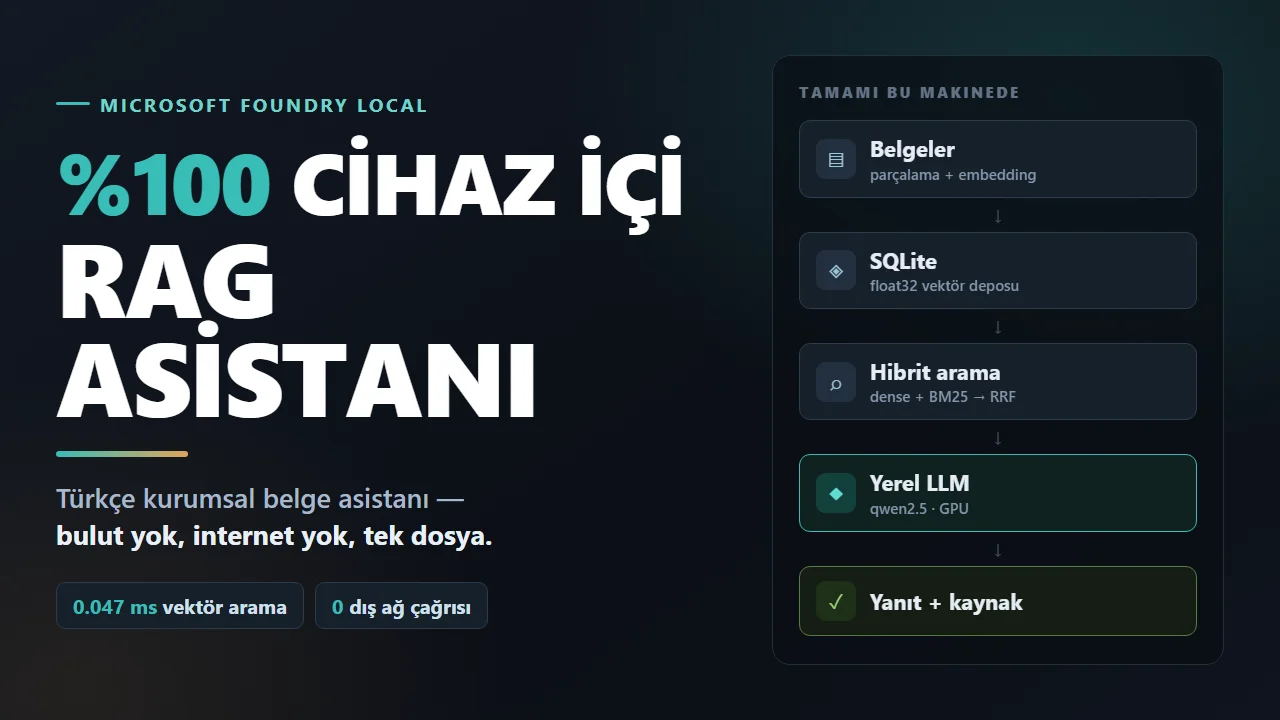
Bu yaz, Microsoft Summer School staj programında bir yapay zekâ projesi geliştirdim: Foundry Core AI. Şirketlerin iç belgelerine (izin politikası, masraf kuralları, VPN kurulumu gibi) soru sorabildiğiniz ve tamamen bilgisayarınızda, internete hiç çıkmadan çalışan bir asistan.
Program online yürüdü ama arada Microsoft Türkiye ofisine ziyaretlerimiz oldu. Her hafta da Microsoft Türkiye'nin üst düzey yöneticileriyle online toplantılar yaptık. Projeyi bu toplantılarda adım adım anlattım. Bu yazıda o süreçte öğrendiklerimi topladım: RAG nedir, embedding ve vektör veritabanı gerçekte ne işe yarar, Türkçe neden işleri zorlaştırır. En önemlisi de bütün testler geçerken asistanın nasıl hâlâ uydurabildiği.
Akademik bir makale yazmadım. "AI engineer olmak istiyorum, nereden başlasam?" diye araştıran birinin okurken sıkılmayacağı, ama okuduktan sonra elinde gerçek bilgi kalacak bir yazı olmasını istedim. Her iddianın arkasında projede yaptığım bir ölçüm var.
1. Problem: ChatGPT sizin şirketinizi tanımaz
Büyük dil modelleri (LLM) internetteki devasa metinlerle eğitilir. Fotosentezi anlatabilirler, Python kodu yazabilirler. Ama sizin şirketinizde yıllık iznin kaç gün olduğunu bilemezler, çünkü o bilgi hiçbir zaman eğitim verilerinde yer almadı.
Akla gelen ilk çözüm, belgeyi kopyalayıp sohbet penceresine yapıştırmak. Bu iki yerde tıkanıyor:
- Gizlilik: Kurumsal belgeleri bulut tabanlı bir yapay zekâya göndermek çoğu şirkette yasak. İçinde kişisel veri varsa KVKK açısından da sorun.
- Ölçek: Yüzlerce sayfa belgeyi her soruda modele vermek hem pahalı hem yavaş. Modelin bir seferde okuyabileceği metin miktarı (bağlam penceresi) da sınırlı.
Benim projem bu iki sorunu birlikte çözmeye çalışıyor: Model de belgeler de aynı bilgisayarda duruyor. Her soruda da belgelerin tamamı değil, yalnızca soruyla ilgili birkaç paragraf modele veriliyor. İkinci kısmın adı RAG.
2. RAG nedir? Bir kütüphaneci benzetmesi
RAG (Retrieval-Augmented Generation, Türkçesiyle "bilgi getirmeyle güçlendirilmiş üretim") fikir olarak çok basit:
Modelden ezberinden cevap vermesini istemek yerine, önce ilgili belgeleri bulup önüne koyar, sonra "bu metne bakarak cevap ver" dersiniz.
Bunu iyi bir kütüphaneciye benzetebilirsiniz. Ona bir soru sorduğunuzda bütün kütüphaneyi ezbere bilmesi gerekmez. Doğru rafa gider, ilgili üç kitabı alır, sayfaları açar ve cevabı oradan okur. RAG'in iki aşaması da tam olarak bu:
- Getirme (Retrieval): Soruyla en ilgili belge parçalarını bul.
- Üretme (Generation): Bu parçaları soruyla birlikte dil modeline ver ve cevabı yazdır.
Kâğıt üzerinde iki adım. Pratikte asıl zorluk ilk adımda: "ilgili parçayı bulmak" sandığınızdan çok daha zor bir problem. Yazının geri kalanının çoğu bu problemle ilgili.
3. Embedding: Kelimeleri sayılara çevirmek
Bilgisayar "izin" ile "tatil" kelimelerinin anlamca yakın olduğunu doğrudan bilemez. Bunu ona öğretmenin yolu metni embedding denen bir sayı listesine (vektöre) çevirmek. Benim projemde her metin parçası 1024 sayıdan oluşan bir vektöre dönüşüyor.
Bu sayıların tek tek bir anlamı yok. Önemli olan şu: anlamca benzer metinler, birbirine yakın vektörler üretir. Basitleştirilmiş bir örnekle:
| Metin | Vektör (temsili, 3 boyut) |
|---|---|
| "Yıllık izin kaç gün?" | [0.82, 0.10, 0.31] |
| "Kaç gün tatil hakkım var?" | [0.79, 0.14, 0.28] |
| "VPN nasıl kurulur?" | [0.05, 0.91, 0.12] |
İlk iki cümlede hiç ortak kelime yok, ama vektörleri neredeyse aynı. Üçüncüsü ise bambaşka bir yönde. İki vektörün ne kadar "aynı yöne baktığını" ölçmek için kosinüs benzerliği kullanılır. Değeri 1'e yaklaştıkça iki metin anlamca daha yakın demektir:
import numpy as np

def kosinus_benzerligi(a, b):
    return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))

izin  = np.array([0.82, 0.10, 0.31])
tatil = np.array([0.79, 0.14, 0.28])
vpn   = np.array([0.05, 0.91, 0.12])

print(kosinus_benzerligi(izin, tatil))  # ~0.99 → çok yakın
print(kosinus_benzerligi(izin, vpn))    # ~0.21 → alakasız
Buna dense (yoğun) arama ya da anlamsal arama deniyor: Sorunun vektörünü çıkarırsınız, belge parçalarının vektörleriyle karşılaştırırsınız, en yakın K tanesini alırsınız. Projede embedding için qwen3-embedding-0.6b modelini kullandım.
4. Parçalama (chunking): Belgeyi nereden keseceksiniz?
20 sayfalık bir politika belgesini tek bir vektöre çevirirseniz, o vektör "her şeyin biraz ortalaması" olur ve hiçbir soruya tam uymaz. Bu yüzden belgeler önce küçük parçalara (chunk) bölünür. Benim ayarım: 1000 karakterlik parçalar, 200 karakter örtüşmeli.
Örtüşme neden gerekli? Şu cümlenin tam ortasından kestiğinizi düşünün:
Parça 1: "...Şehir içi iş yemeklerinde kişi başı üst"
Parça 2: "limit 750 TL'dir. Müşteri ağırlama yemeklerinde..."
Artık iki parçanın hiçbiri tek başına soruyu cevaplayamıyor. Örtüşme sayesinde her parçanın sonundaki 200 karakter bir sonrakinin başında tekrar ediyor ve sınırda kalan cümle bütün hâliyle en az bir parçaya giriyor.
Projenin son aşamasında parent-child retrieval denen bir yöntemi de denedim. Arama küçük ve isabetli "çocuk" parçalar üzerinde yapılıyor, modele ise onları kapsayan daha büyük "ebeveyn" parça veriliyor. Küçük parça doğru yeri bulmakta iyi, büyük parça modele yeterli bağlamı vermekte. İkisini birleştirmek mantıklı geliyor. Ama bu da (yazının ilerisinde göreceğiniz gibi) ölçülmeden iyi ya da kötü denemeyecek bir değişiklik.
5. Vektör veritabanı: Gerçekten gerekli mi?
RAG öğreticilerinin neredeyse hepsi şöyle başlar: "Önce bir vektör veritabanı kurun: Chroma, FAISS, Pinecone..." Ben de öyle başlayacaktım. Önce ölçmeye karar verdim.
Vektör veritabanının temel işi, milyonlarca vektör arasından en yakınları hızlıca bulmak. Peki benim ölçeğimde arama ne kadar sürüyor? Python'daki NumPy kütüphanesiyle "kaba kuvvet" denemesi yaptım, yani soruyu her vektörle tek tek karşılaştırdım:
| Parça sayısı | Arama süresi |
|---|---|
| 44 (projenin o anki hâli) | 0.01 ms |
| 10.000 | 1.58 ms |
| 100.000 | 21.65 ms |
| 500.000 | 103 ms |
Yaklaşık 25.000 belgelik bir şirkette bile arama 22 milisaniye sürüyor. Bir de karşılaştırma için: Yanıtın tamamı, yani dil modelinin cevabı yazması, 12–17 saniye sürüyor. Arama kısmını hızlandırmak için ayrı bir veritabanı kurmak, toplam sürenin binde birini kurtarmak demek.
Bu yüzden harici vektör veritabanı kullanmadım. Vektörleri doğrudan SQLite içinde ikili veri (BLOB) olarak sakladım ve aramada hepsini tek bir matris çarpımıyla karşılaştırdım:
# Vektörü kaydederken: 1024 float → 4 KB ikili veri
blob = np.asarray(vektor, dtype=np.float32).tobytes()

# Okurken: ayrıştırma maliyeti sıfır
vektor = np.frombuffer(blob, dtype=np.float32)

# Arama: tüm parçalar tek matriste, benzerlik tek çarpımla
skorlar = matris @ sorgu_vektoru      # (N, 1024) @ (1024,) → (N,)
en_iyi  = np.argsort(skorlar)[::-1][:3]
Küçük ama önemli bir detay: Başta vektörleri JSON metni olarak saklıyordum. 1024 sayılık bir vektör JSON olarak ~20 KB, ikili veri olarak 4 KB yer kaplıyor. Bu geçişle veritabanı dosyası 1304 KB'tan 296 KB'a indi.
Vektör veritabanları kötü değil. Yüz binlerce parçanın üstüne çıkınca, özellikle RAM'e sığmayan veriler için çok değerliler. Ama "herkes kullanıyor" iyi bir sebep değil. Bu projede harici veritabanı eklemek ürünün asıl vaadini bozardı: tek dosya, sunucusuz, kurulumsuz.
6. Türkçe, anlamsal aramayı kırıyor
İngilizce öğreticilerde anlatılmayan ve beni en çok uğraştıran kısım burasıydı.
Türkçe sondan eklemeli bir dil. "izin", "izinler", "izinlerin", "izne", "iznimi" aynı kelimenin farklı biçimleri. Küçük bir embedding modelinde bu biçimler arasındaki benzerlik bazen konusu alakasız ama yüzeyi yakın bir parçanın benzerliğinden düşük kalıyor. Kullanıcının tam olarak yazdığı kelimeyi içeren parça ilk 3'e giremiyor.
Çözüm: Hibrit arama
Aramayı iki ayaklı yaptım:
- Dense arama: Anlamı yakalar. "Tatil hakkı" sorusunda "yıllık izin" geçen parçayı bulur.
- BM25 (kelime araması): Kullanıcının yazdığı kelimenin birebir geçtiği yeri bulur. Bunu ek bir bağımlılık kurmadan SQLite'ın kendi tam metin arama modülü FTS5 ile yaptım.
Sorun şu: İki yöntemin skorları farklı ölçeklerde. Kosinüs benzerliği 0 ile 1 arasında, BM25 skorunun ise bir üst sınırı yok ve belge koleksiyonuna göre değişiyor. İkisini toplayamazsınız. Bunun yerine Reciprocal Rank Fusion (RRF) kullandım. RRF skorlara bakmaz, yalnızca sıralamalara bakar:
RRF_skoru(parça) = Σ  1 / (k + sıra)      # k = 60, literatürdeki standart değer

Örnek: Bir parça dense aramada 1., BM25'te 3. sırada:
  1/(60+1) + 1/(60+3) = 0.0164 + 0.0159 = 0.0323

Başka bir parça yalnızca dense aramada 2. sırada:
  1/(60+2) = 0.0161
İki listede birden üst sıralarda çıkan parça doğal olarak öne geçiyor ve hiçbir ölçek kalibrasyonu gerekmiyor.
Türkçeye özgü iki küçük hile
1. Ucuz bir kök bulucu olarak ön-ek eşleşmesi. Türkçede ekler kelimenin sonuna geldiği için arama terimini 5 karaktere kırpıp parol* şeklinde aramak "parola", "parolalar", "parolamız" biçimlerinin hepsini tek seferde yakalıyor. Tam bir morfolojik çözümleyici kurmadan sorunun büyük kısmı çözülüyor.
2. "ı" bir aksan değildir. Bu beni bir süre uğraştırdı. SQLite'ın aksan temizleme seçeneği "ü→u", "ö→o" dönüşümünü yapıyor ama "ı" harfini ayrı bir harf kabul ediyor. Python'un lower() fonksiyonu ise "I" harfini "i" yapıyor, oysa Türkçede doğrusu "ı". Kurumsal belgeler de çoğu zaman Türkçe karaktersiz yazıldığı için ("BILGI GUVENLIGI"), kullanıcı "güvenliği" yazınca kelime araması hiçbir şey bulamıyordu. Çözüm, normalizasyonu elle yazmak ve sırayı doğru kurmaktı:
_TR_MAP = str.maketrans("çğıöşüÇĞİÖŞÜ", "cgiosuCGIOSU")

def normalize_tr(metin: str) -> str:
    # Önce katla, SONRA küçült. Ters sırada "I" yanlış harfe dönüşür.
    return metin.translate(_TR_MAP).lower()

normalize_tr("GÜVENLİĞİ")    # → "guvenligi"
normalize_tr("Yıllık İzin")  # → "yillik izin"
Buradan çıkardığım ders: İngilizce üzerine kurulmuş RAG tarifleri Türkçeye olduğu gibi taşınamıyor. Dilin yapısı, arama mimarisini baştan belirleyen bir tasarım kısıtı.
7. Modeli kendi bilgisayarınızda çalıştırmak
Projenin temelinde Microsoft Foundry Local var. Dil modellerini bilgisayarınıza indirip çalıştıran, OpenAI uyumlu bir API sunan bir araç. Model bir kez indirildikten sonra internete ihtiyaç kalmıyor ve Azure aboneliği gerekmiyor.
Benim dizüstü bilgisayarımda yalnızca 2 GB ekran kartı belleği (VRAM) var. Bu kısıt, bir dizi yanlış tahminimi ortaya çıkardı.
"Daha akıllı" model her zaman daha iyi değil
İlk denediğim model düşünme yeteneği olan (reasoning) küçük bir modeldi. Bu modeller cevap vermeden önce <think> bloğu içinde uzun uzun "düşünüyor". Sorun şu: O düşünme metni de token bütçesinden harcanıyor. Bütçe düşünme bloğunun ortasında bitince kullanıcıya boş bir yanıt dönüyordu. Yani daha çok düşünen model, küçük bütçede hiç cevap veremiyordu. Düşünme bloğu üretmeyen qwen2.5-1.5b modeline geçtim.
İki model aynı anda sığmıyor
Embedding modelini ve sohbet modelini aynı anda ekran kartına yüklediğimde belirtiler tuhaftı: Yanıtlar 80 saniye sürüyordu ve metin bozuktu, aynı heceler tekrar tekrar geliyordu. Sebep VRAM taşmasıydı. Çözüm, embedding modelini işlemciye (CPU) almaktı:
- Embedding'in çoğu bir kez yapılıyor. Belge parçası bir kez vektöre çevriliyor ve veritabanında duruyor. Sorgu anında yalnızca tek bir kısa cümle işleniyor.
- Sohbet modeli ise her soruda token token çalışıyor ve kullanıcının beklediği sürenin tamamını oluşturuyor.
Sonuç: Yanıt süresi 80 saniyeden 12–17 saniyeye indi ve çıktı düzeldi. Hangi modelin GPU'da kalacağına iş yükünün şekline bakarak karar vermek gerekiyor.
8. Projenin en önemli dersi: Testler yeşildi, asistan uyduruyordu
Bu bölüm, staj boyunca öğrendiğim her şeyin özeti sayılır.
Projede 155 birim testi vardı ve hepsi geçiyordu. Arama çalışıyor, embedding üretiliyor, API doğru yanıt dönüyor, veritabanı tutarlı. Proje "bitmiş" görünüyordu.
Sonra kodu değil, asistanın cevaplarını ölçen ayrı bir set yazdım. 23 soruyu üç gruba ayırdım:
- Cevaplanabilir: Cevabı belgelerde olan sorular.
- Cevaplanamaz: Cevabı belgelerde olmayan sorular. Doğru davranış "bilmiyorum" demek.
- Tuzak: Belgelerde anahtar kelimesi geçen ama cevabı olmayan sorular.
İlk sonuç:
| Kategori | Sonuç |
|---|---|
| Cevaplanabilir | 11 / 12 |
| Cevaplanamaz | 1 / 4 |
| Tuzak | 0 / 3 |
Asistan, bilmediği şeylerin dörtte üçünde bilgi uyduruyordu. Gerçek ölçümden iki örnek:
Soru: Ofisteki toplantı salonunun aylık kirası ne kadar?
Yanıt: "Aylık toplantı salonunun kirası, 2026 yılı için 240 TL'dir."
Belgelerde "kira" kelimesi yalnızca "araç kiralama" olarak geçiyor. Rakam da yıl da tamamen uydurma ve çok inandırıcı.
Soru: Şirketin 2025 yılı cirosu ne kadardır?
Yanıt: "2025 yılı cirosu 14 işgünlüğü yıllık izne hak kazandırmaktadır."
İzin politikasındaki bir sayıyı ciro sorusuna yapıştırmış.
Ders: Klasik yazılımda "testler geçiyor" ile "sistem doğru çalışıyor" büyük ölçüde aynı şeydir. Yapay zekâ sistemlerinde değildir. Birim testi kodun doğru çalıştığını kontrol eder, modelin doğru davrandığını kontrol etmez. Model davranışı ancak ölçülerek bilinir. Bir RAG projesinde değerlendirme seti opsiyonel bir ekstra değil, testlerle eşit ağırlıkta ikinci bir disiplin.
Kök neden: Kuralların sırası
Uydurmanın sebebi beklediğimden çok daha basit çıktı. Sistem promptunun ilk hâli şöyleydi:
Sen kurumsal bir bilgi asistanısın. BAĞLAM bilgilerini kullanarak
kullanıcının sorusuna doğrudan ve net bir yanıt ver.

Kurallar:
1. Sadece BAĞLAM içindeki gerçekleri kullan.
2. Kullanıcının dilinde yaz.
3. [Kaynak: dosya_adı] ekle.
4. BAĞLAM'da bilgi yoksa "bilgi bulunmuyor" de.
Prompt "yanıt ver" emriyle başlıyor, yani modele varsayılan davranış olarak cevap vermesini söylüyor. Reddetme kuralı da en sonda, dördüncü sırada. Yalnızca bu kuralı en başa, ilk kontrol olarak taşıdım ve "bağlamda geçmeyen sayı, tutar veya tarih üretme" ifadesini ekledim:
| Kategori | Önce | Sonra |
|---|---|---|
| Cevaplanabilir | 11 / 12 | 11 / 12 |
| Cevaplanamaz | 1 / 4 | 3 / 4 |
| Genel | %60 | %74 |
1.5 milyar parametreli küçük bir model, talimatları eşit ağırlıkta değerlendirmiyor. Listenin sonundaki kısıt baştaki emrin altında eziliyor. Büyük modeller buna daha dayanıklı. Küçük modelde ise promptun yapısı bir detay değil, sistemin davranışını belirleyen asıl etken.
Prompt sınırlı bir dikkat bütçesidir
Aynı 23 soruyla, her seferinde tek bir şeyi değiştirerek birkaç deney daha yaptım:
| Deney | Genel başarı |
|---|---|
| Reddetme kuralı başta, kaynak gösterme kuralı var | %74 |
| Gözlenen hatalar için iki yeni kural eklendi | %58 ↓ |
| Modelin zaten uymadığı kaynak kuralı silindi | %79 ↑ |
| Prompt İngilizceye çevrildi | %63 ↓ |
İki sonuç sezgime tamamen ters geldi:
- Kural eklemek, o kuralın getirdiği davranışı kazandırmıyor. Hatayı hedefleyen iki kural mantıklı görünüyordu ama başarı %74'ten %58'e düştü. Yeni kurallar, en önemli kural olan reddetme talimatını zayıflattı.
- Modelin uymadığı bir kural bedava değil. Model
[Kaynak: ...]kuralına zaten uymuyordu (kaynakları arayüz kendisi gösteriyor). Bu işe yaramayan kuralı silmek başarıyı %79'a çıkardı.
İngilizce prompt denemesi de ilginçti. Model talimatlara daha iyi uydu ama Türkçe belgelerin içinden yanlış cümleyi seçmeye başladı. Bundan çıkan sonuç "İngilizce prompt kötüdür" değil. Asıl bulgu şu: talimat dili ile belge dili farklı olduğunda bunun bir bedeli var.
9. Benzerlik skoru, cevabın orada olduğunu göstermez
Bu, projenin bence en öğretici bulgusu. Ölçülen benzerlik skorlarına bakın:
- Doğru cevaplanan sorular: 0.335, 0.418, 0.429, 0.445, 0.485 ... 0.655
- Uydurulan sorular: 0.281, 0.304, 0.322, 0.329, 0.349, 0.482
"Toplantı salonunun kirası" sorusu 0.482 benzerlikle bir parça getirdi. Bu, doğru cevaplanan soruların çoğundan daha yüksek bir skor. Getirilen parça gerçekten konuyla ilgiliydi: İçinde toplantı salonu geçiyordu ama kira geçmiyordu.
Buradan iki ayrı hata türü olduğu ortaya çıktı:
| Hata türü | Belirti | Eşik değeri çözer mi? |
|---|---|---|
| A: Alakasız parça geçiyor | Düşük benzerlik (0.28–0.33) | Evet |
| B: İlgili ama cevabı içermeyen parça | Yüksek benzerlik (0.48) | Hayır |
"Bu parça soruyla ilgili mi?" ile "Bu parça sorunun cevabını içeriyor mu?" iki ayrı soru. Kosinüs benzerliği yalnızca birincisini ölçüyor. Eşiği 0.48'in üstüne çıkarsaydım B tipi hatayı çözerdim, ama doğru cevapların yarısını da kaybederdim. Bu ayrımı görmeden bir RAG sistemini ayarlamaya çalışmak, eşik değerini sonsuza kadar ileri geri oynatmak demek.
Kendi test setinize ezberletmeyin
Ölçümler, eşiği 0.35'ten 0.40'a çıkarmanın birkaç hatayı daha düzelteceğini açıkça gösteriyordu. Bunu bilerek yapmadım. Elimde 23 soru vardı. Eşiği bu 23 soruya göre ayarlasaydım, eşik bu sorulara "ezberlenmiş" olurdu ve "sistem iyileşti" iddiası anlamsızlaşırdı. Makine öğrenmesindeki eğitim/doğrulama ayrımı, model eğitmediğiniz ve yalnızca birkaç ayar seçtiğiniz durumda bile geçerli.
10. Yavaşlığın asıl sebebi tahmin ettiğim yer değildi
Sezgi şunu söyler: Model yavaşsa kelime üretimi yavaştır, o yüzden streaming (cevabı token token göstermek) işi çözer. Ölçüm bunu çürüttü:
Vektör arama            :   0.047 ms
Sorgu embedding + arama :  ~1.6 sn
İlk token'a kadar       :  15.4 sn   ← darboğaz burada
Cevabın üretilmesi      :  ~1.3 sn   (19 token/sn)
Zamanın neredeyse tamamı ilk kelime gelmeden önce geçiyor. Model önce verdiğiniz bütün bağlamı okuyup işliyor (prefill). Bağlam uzunluğunu değiştirerek ölçtüm:
| Modele verilen bağlam | İlk token süresi |
|---|---|
| 0 karakter | 4.08 sn |
| 500 karakter | 6.85 sn |
| 1000 karakter | 7.66 sn |
| 2144 karakter | 16.80 sn |
Benim sistemimde cevabın üretimi 16 saniyenin yalnızca 1 saniyesi. Yani streaming algılanan hıza neredeyse hiçbir şey katmıyor, kullanıcı ilk kelimeyi görmek için yine 15 saniye bekliyor. Mimari sonuç: Yerel RAG'de bağlam uzunluğu yalnızca bir kalite ayarı değil, gecikmeyi belirleyen birinci ayar. Modele daha çok parça göndermek "biraz daha yavaş" değil, katlanarak daha yavaş demek.
11. En iyi optimizasyon: Modeli hiç çağırmamak
Benzerlik eşiğini başta yalnızca alakasız parçaları elemek için koymuştum. Sonra ikinci bir faydası ortaya çıktı: Eşiği geçen hiçbir parça yoksa dil modeli hiç çalıştırılmıyor ve doğrudan "belgelerde bu bilgi yok" yanıtı dönüyor.
- Doğruluk: Model devrede olmadığı için uydurma ihtimali sıfır.
- Hız: Bu yolla reddedilen bir soru 6.7 saniyede yanıtlandı, modele giden sorular ise ~15 saniye sürdü.
RAG sistemlerinde "modeli çağırmamaya karar vermek" başlı başına bir tasarım kararı ve çoğu öğreticide atlanıyor.
12. En sinsi hata: Yakın ama yanlış
Soru: Şehir içi iş yemeklerinde kişi başı üst limit nedir?
Belge: "Şehir içi iş yemeklerinde kişi başı üst limit 750 TL'dir. Müşteri ağırlama yemeklerinde limit kişi başı 1.500 TL'dir..."
Yanıt: 1.500 TL
Doğru belge, doğru parça getirildi ve cevap parçanın içindeydi. Model aynı paragraftaki iki sayıdan yanlışını seçti. Bu hata ne aramayla ne parçalama stratejisiyle çözülebiliyor, çünkü iki bilgi yan yana duruyor. Saf bir model kavrama sınırı.
Bence en tehlikeli hata türü bu: Sistem kendinden emin, kaynak doğru, sayı belgede gerçekten geçiyor. Kullanıcının yanlış olduğunu anlamasının hiçbir yolu yok. Hukuk, sağlık, finans gibi kritik alanlarda küçük modellerle çalışmamanın asıl sebebi bu.
13. Staj sürecinin bana kattıkları
Teknik kısmın dışında, programın kendisi de öğreticiydi. Haftalık toplantılarda projeyi Microsoft Türkiye yöneticilerine anlatmak bir alışkanlık kazandırdı: "Ne yaptım" yerine "neyi neden yaptım, nasıl ölçtüm" diye anlatmak. "Hızlandırdım" demek yetmiyor, "80 saniyeden 15 saniyeye indi, çünkü..." diyebilmek gerekiyor. Projedeki her teknik kararı ayrı bir mimari karar kaydında (ADR) belgelemem de buradan geldi: Hangi alternatifleri düşündüm, neden reddettim, bedeli ne.
Ofis ziyaretleri ise büyük bir teknoloji şirketinin bir ürüne nasıl baktığını yakından görme fırsatıydı. Çalışan bir demo ile bir firmaya kurulabilecek ürün arasında büyük bir fark var. Projeyi "ödev" olmaktan çıkarıp kimlik doğrulama, kurulum betiği ve güvenlik katmanı eklememin sebebi biraz da bu.
14. AI engineer olmak isteyenlere: Bu projeden çıkardığım yol haritası
- Önce temeli öğrenin: Embedding, kosinüs benzerliği ve parçalama. Bunları bir kütüphane kullanmadan, NumPy ile 50 satırda kendiniz yazın. Neyin neden çalıştığını o zaman anlıyorsunuz.
- Hazır vektör veritabanına hemen atlamayın: Önce kaba kuvvet aramayı ölçün. Çoğu proje sandığınızdan küçük.
- Kendi dilinizi ciddiye alın: Türkçe bir sistem kuruyorsanız hibrit arama ve normalizasyon neredeyse zorunlu.
- İlk günden bir değerlendirme seti yazın: Cevaplanabilir, cevaplanamaz ve tuzak sorular. 20 soru bile yeter. Bu set olmadan yaptığınız her iyileştirme bir tahmin.
- Her seferinde tek bir şeyi değiştirin ve ölçün: Prompt, eşik, model. "Sanırım daha iyi oldu" ile "reddetme oranı 1/4'ten 3/4'e çıktı" arasındaki fark, mühendislikle deneme-yanılma arasındaki fark.
- Gecikmeyi parçalarına ayırın: Arama, prefill, üretim. Darboğaz çoğu zaman sandığınız yerde değil.
Son söz
Bu projeden aklımda kalan en önemli cümle şu: Yapay zekâ sistemlerinde çalışan kod ile doğru davranan sistem aynı şey değil. Aradaki boşluğu yalnızca ölçüm gösteriyor ve ölçmediğiniz bir sistem tam en çok güvendiğiniz anda uydurabiliyor.
Projenin kaynak kodu, mimari karar kayıtları ve değerlendirme sonuçları GitHub'da: github.com/Erkan3034/foundry-core-ai. Sorularınız ya da önerileriniz varsa iletişim sayfasından bana yazabilirsiniz.
Kısa sözlük
| Terim | Anlamı |
|---|---|
| LLM | Büyük dil modeli. Metin üreten yapay zekâ modeli. |
| RAG | Önce ilgili belgeleri bulup sonra modele bunlara bakarak cevap yazdırma yöntemi. |
| Embedding | Metnin anlamını temsil eden sayı listesi (vektör). |
| Kosinüs benzerliği | İki vektörün ne kadar aynı yöne baktığını ölçen değer (0–1). |
| Chunk | Belgenin aranabilir küçük parçası. |
| BM25 | Kelime eşleşmesine dayalı klasik arama algoritması. |
| RRF | Farklı arama sonuçlarını sıralamalarına göre birleştirme yöntemi. |
| Prefill | Modelin cevap yazmadan önce verilen metnin tamamını işlediği aşama. |
| Token | Modelin metni işlediği en küçük birim (kelime veya kelime parçası). |